كيف تحوّل ملاحظاتك وشرائحك إلى اختبار تدريبي يرسخ فعلًا
سجّل المحتوى المختبَر 92% في امتحان الوحدة مقابل 79% للمحتوى غير المختبَر لدى الطلاب أنفسهم. ومولّد الاختبارات بالذكاء الاصطناعي يجعل ذلك ممكنًا لكل محاضرة، إذا أجريت الاختبار أولًا، وقرأت كل شرح، وأصلحت الأسئلة التي يخطئ فيها الذكاء الاصطناعي. إليك الطريقة، والأدلة، وتكلفة الأدوات.
"شرائح محاضرتك تحتوي أصلًا على كل سؤال في الامتحان. مولّد الاختبارات بالذكاء الاصطناعي يطرحها عليك فقط قبل أن يطرحها الأستاذ."
يحوّل مولّد الاختبارات بالذكاء الاصطناعي ملاحظاتك أو شرائحك إلى اختبار تدريبي في نحو دقيقة: ترفع الملف، وتختار عدد الأسئلة، فتحصل على أسئلة اختيار من متعدد مكتوبة من ذلك المستند، لكل منها إجابة صحيحة واحدة وشرح قصير. هذا الجزء سهل في 2026. أما الجزء الذي يحدد إن كان سيحسّن درجتك فهو ما تفعله بالاختبار، وهذا ما يدور حوله هذا الدليل.
المخاطر حقيقية. في تجربة كلاسيكية، توقّع الطلاب أن إعادة القراءة ستمنحهم أفضل احتفاظ طويل الأمد وأن اختبار أنفسهم سيمنحهم الأسوأ. وبعد أسبوع واحد، سجّلت المجموعة التي اختبرت نفسها درجات أعلى بنحو 50% من المجموعة التي رسمت خرائط مفاهيم بدلًا من ذلك (Karpicke & Blunt, Science, 2011). الطلاب يخطئون باستمرار في تقدير ما ينجح. والاختبار المُنشأ من موادك الخاصة يجعل الأسلوب الفعّال هو الأسلوب السهل.
أبرز النقاط
- الاختبار في مادة المقرر يرفع درجات الامتحان: في صف علوم بالمرحلة المتوسطة، سجّل المحتوى الذي اختُبر فيه الطلاب 92% في امتحان الوحدة مقابل 79% للمحتوى غير المختبَر لدى الطلاب أنفسهم، ووجد تحليل تجميعي لمقررات علم نفس حقيقية أثرًا قدره d = 0.56.
- إنشاء اختبار من ملاحظاتك أو شرائحك يستغرق أربع خطوات ونحو دقيقة: ارفع ملف PDF نصيًا أو DOCX أو EPUB، وحدّد الاختيار من متعدد، واختر من 5 إلى 20 سؤالًا، ثم أجب بالمفاتيح من 1 إلى 4 واقرأ كل شرح.
- أجرِ الاختبار قبل أن تقرأ الفصل. عبر خمس تجارب، تذكّر الطلاب الذين خمّنوا أولًا ثم قرؤوا أكثر من الطلاب الذين مُنحوا وقت قراءة إضافيًا بدلًا من ذلك، رغم أنهم أخطؤوا في معظم أسئلة الاختبار القبلي.
- التغذية الراجعة هي الرافعة الكبرى: بعد أسبوع، استرجع الطلاب الذين تلقّوا تغذية راجعة بعد اختبار اختيار من متعدد من 60 إلى 70% مقابل 42% دونها. ومن دونها قد تُحفظ الخيارات الخاطئة على أنها حقائق.
- راجِع أسئلة الذكاء الاصطناعي. في امتحان طبي حقيقي، كان 14% من الأسئلة التي كتبها الذكاء الاصطناعي بمستوى صعوبة غير مناسب و6% خاطئة علميًا؛ وبعد جولة تحرير من خبير، لم يستطع الطلاب التمييز بين أسئلة الذكاء الاصطناعي وأسئلة البشر.
جزء من دليلنا حول كيفية الدراسة بالذكاء الاصطناعي في 2026. الاختبار واحد من سبعة مخرجات من الرفع نفسه؛ ويتناول دليل تحويل PDF إلى بطاقات تعليمية شقيقه.
لماذا يتفوّق اختبارٌ من ملاحظاتك على إعادة قراءتها
ينجح الاختبار المبني من ملاحظاتك لأنه يجبرك على استخراج كل معلومة من الذاكرة، وكل استرجاع يقوّي الذي يليه. أما إعادة قراءة الملاحظات نفسها فتبدو أسلس في كل مرة، وهذا بالضبط سبب خداعها لك: الطلاقة ليست ذاكرة. هذا هو أثر الاختبار، وقد قيس في فصول دراسية حقيقية، لا في المختبرات فقط.
أوضح برهان صفّي اختبر طلاب العلوم في الصف الثامن في جزء من محتوى الوحدة دون الباقي. في امتحان الوحدة، سجّلت المادة المختبَرة 92% مقابل 79% للمادة غير المختبَرة لدى الطلاب أنفسهم في الصف نفسه. وظلّت الأفضلية قائمة في نهاية الفصل الدراسي (79% مقابل 72%) وفي نهاية العام (68% مقابل 62%) (McDaniel et al., Journal of Educational Psychology, 2011).
النمط نفسه يصمد على المستوى الجامعي. وجد تحليل تجميعي اقتصر على مقررات علم نفس حقيقية، يضم 72 حجم أثر عبر 19 منشورًا، أن الاختبار حسّن نتائج التعلم بحجم أثر d = 0.56 (Schwieren, Barenberg & Dutke, Psychology Learning & Teaching, 2017). وفي أكبر تجميع للدراسات الصفية، 222 دراسة تغطي 48,478 طالبًا، رفع الاختبار التحصيل بأثر متوسط قدره g = 0.50 (Yang et al., Psychological Bulletin, 2021).
حتى وقت قريب كانت المشكلة أن على أحدٍ ما أن يكتب الاختبار، وكثير من المقررات لا تجري اختبارات إلا بضع مرات في الفصل الدراسي. مولّد الاختبارات بالذكاء الاصطناعي الذي يعمل من شرائحك يزيل هذا القيد: يمكن اختبار أي محاضرة في المساء نفسه، وتبقى الأسئلة مرتبطة بما سيغطيه امتحانك فعلًا لا بالمعرفة العامة لروبوت محادثة عن المادة.
كيف تنشئ اختبارًا من الملاحظات أو الشرائح، خطوة بخطوة
تستخدم الطريقة أدناه أداة الاختيار من متعدد في مركز الدراسة في ReadLoudly، وهي مجانية ضمن حصة يومية وتُنشئ الأسئلة من المستند الذي ترفعه. الخطوات الثلاث الأولى هي الآلية. أما الخطوة الرابعة والأقسام التي تليها فهي ما يحوّل الاختبار إلى درجة.
ضع ملاحظاتك أو شرائحك في ملف نصي
صدّر شرائح المحاضرة إلى PDF (يتيح ذلك PowerPoint وKeynote وGoogle Slides جميعًا)، أو احفظ الملاحظات المكتوبة بصيغة DOCX، أو استخدم ملف PDF أو EPUB لفصل الكتاب المدرسي. يجب أن يحتوي الملف على نص حقيقي قابل للتحديد: يرفض مركز الدراسة ملفات PDF الممسوحة ضوئيًا أو المكوّنة من صور فقط عند الرفع، لأن صورة الصفحة لا تحتوي على نص تُكتب منه الأسئلة. محاضرة واحدة أو فصل واحد في كل رفع يعطي أسئلة أدق من تفريغ الفصل الدراسي كله، لأن المولّد يوزّع أسئلته على المستند، فيحصل ملف الفصل الدراسي الكامل على تغطية ضعيفة.
ارفع الملف، وحدّد الاختيار من متعدد، واختر عدد الأسئلة
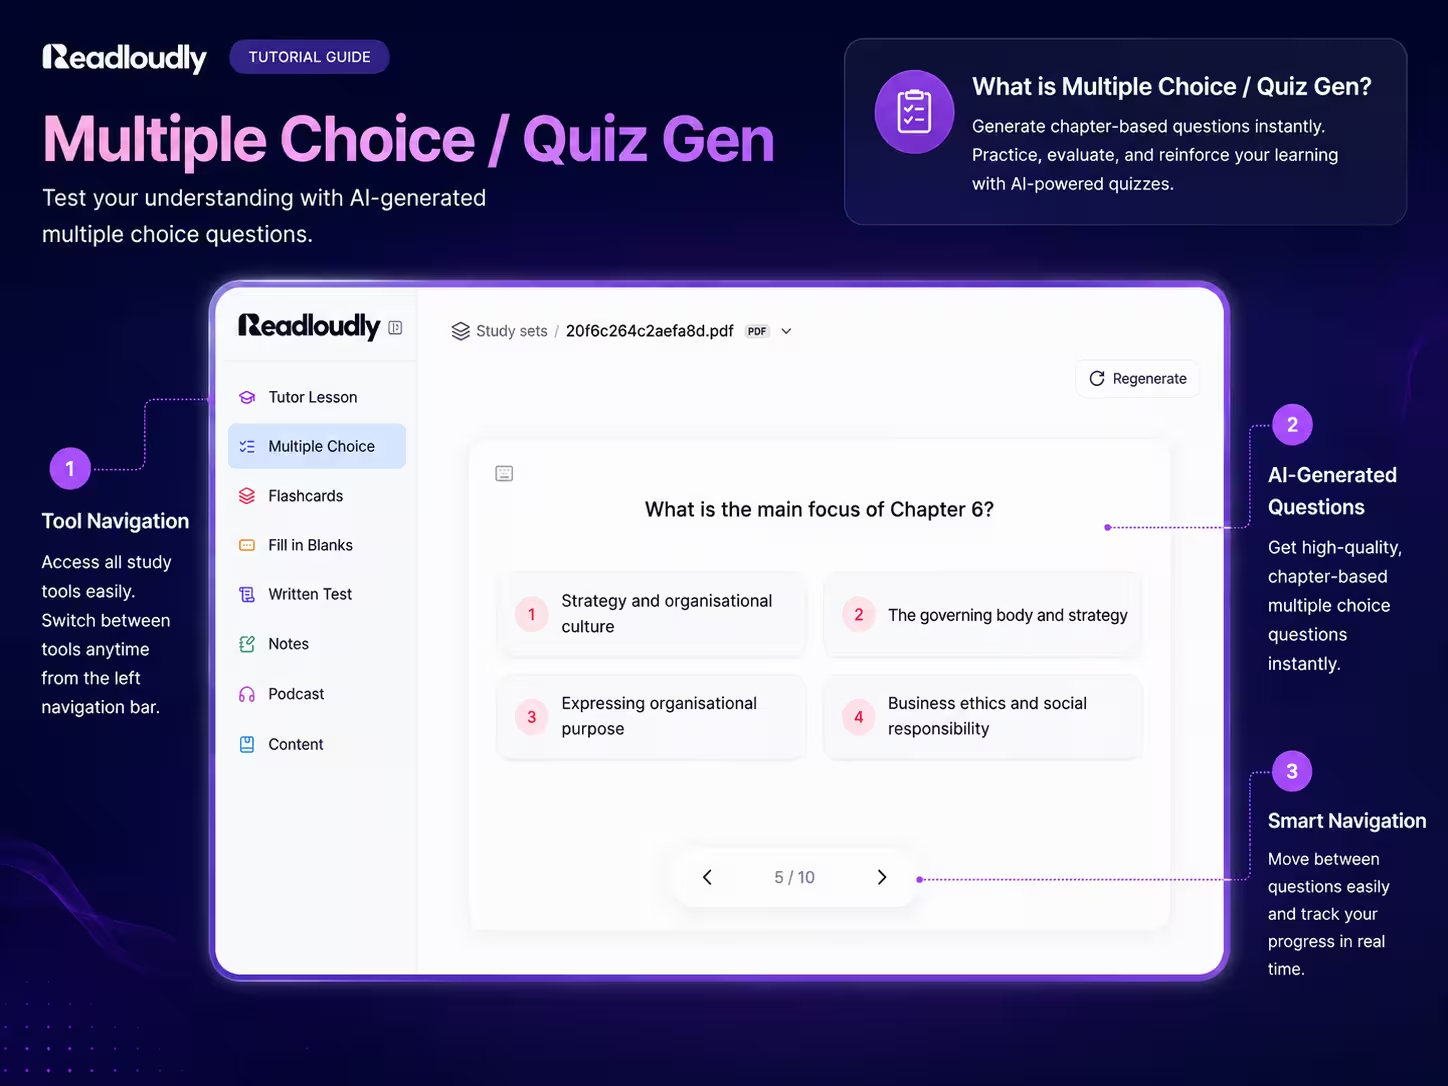
افتح مركز الدراسة، وسجّل الدخول (مجانًا)، وارفع الملف، وحدّد الاختيار من متعدد في شاشة الإعداد. اختر 5 أو 10 أو 15 أو 20 سؤالًا؛ العشرة تناسب محاضرة واحدة، والعشرون فصلًا كثيفًا. هذا هو الإعداد الوحيد. ويمكنك تحديد البطاقات التعليمية في الخطوة نفسها إن أردت مجموعة بطاقات من الرفع نفسه.
أنشئ الاختبار، ثم أجرِه دون تحضير
يستغرق الإنشاء نحو دقيقة. يحصل كل سؤال على أربعة خيارات بالضبط وإجابة صحيحة واحدة وشرح قصير، والمولّد موجَّه لكتابة أسئلة يمكن الإجابة عنها من مستندك فقط دون أسئلة خادعة. أجرِ الاختبار قبل أن تعيد قراءة أي شيء: اضغط من 1 إلى 4 لاختيار إجابة، ثم إرسال، واقرأ الشرح، ثم Enter للسؤال التالي. وفي النهاية ترى عدد الإجابات الصحيحة من المجموع.
راجِع الأسئلة التي أخطأت فيها مقابل المصدر
المستند الأصلي على بُعد نقرة واحدة في الشريط الجانبي. لكل خطأ، ابحث عن المقطع، وتحقق من أن الشرح يطابقه، واكتب سؤالًا أصعب واحدًا من نوع "لماذا" أو "ماذا لو" بنفسك في لوحة الملاحظات. تميل اختبارات الذكاء الاصطناعي إلى التذكّر، ويشرح القسم الخاص بأخطاء الذكاء الاصطناعي لماذا تهمّ هذه المراجعة ذات الدقيقتين أكثر من محاولة ثانية.
يبقى الاختبار محفوظًا تحت المستند، فيمكنك إعادته بعد أسبوع أو في شهر الامتحانات. وفي الخطة المدفوعة، يكتب زر إعادة الإنشاء مجموعة جديدة من الأسئلة من الرفع نفسه، وهكذا تحصل على اختبار ثانٍ في الفصل دون أن ترفعه مرتين.
أجرِ الاختبار قبل أن تقرأ الفصل
أنشئ الاختبار من الشرائح قبل المحاضرة، أو من الفصل قبل أن تقرأه، وأجرِه أولًا. الإجابات الخاطئة هي المقصود. هذا هو أثر الاختبار القبلي، وهو من أقل نتائج علم التعلم استخدامًا لأنه يبدو معكوسًا.
في الدراسة المرجعية، إما أجاب الطلاب عن أسئلة حول مقالة قبل قراءتها أو حصلوا على وقت قراءة إضافي بدلًا من ذلك. ولم تُحتسب لاحقًا إلا الأسئلة التي أخطؤوا فيها في الاختبار القبلي. في التجارب الخمس كلها، تذكّرت مجموعة الاختبار القبلي أكثر: 75% مقابل 56% في الأولى، و82% مقابل 64% في الثالثة، و90% مقابل 63% في الخامسة، و55% مقابل 45% بعد أسبوع كامل، رغم أن دقة الاختبار القبلي انخفضت إلى 5% (Richland, Kornell & Kao, Journal of Experimental Psychology: Applied, 2009).
قارنت دراسة متابعة أكبر شملت 1,573 مشاركًا بين الاختبار قبل الدراسة والاختبار بعدها. تفوّق كلاهما على عدم الاختبار إطلاقًا، لكن الاختبار القبلي أعطى درجات إجمالية أعلى، مع أفضلية 18% في الأسئلة المختبَرة بعد 48 ساعة، لكن 1% فقط في الأسئلة التي لم تُطرح، لذا أنشئ أسئلة عن كل ما تحتاج إلى معرفته (Pan & Sana, Journal of Experimental Psychology: Applied, 2021). النسخة العملية: ارفع الشرائح التي نشرها الأستاذ، وأنشئ عشرة أسئلة، وأجب عنها في الحافلة، ثم احضر المحاضرة وأنت تعرف مسبقًا الأجزاء التي لا تستطيع الإجابة عنها.
اقرأ الشرح في كل مرة: لماذا تهمّ التغذية الراجعة
لا تتخطَّ الشرح بعد أي سؤال، حتى السؤال الذي أجبت عنه صحيحًا. من أكبر العوامل التي تحدد ما إذا كان اختبار الاختيار من متعدد يفيدك هو أن ترى الإجابة الصحيحة بعده، ويكبر هذا الأثر كلما ابتعد موعد الامتحان.
في التجربة الأساسية، قرأ الطلاب مقاطع قصيرة، وأجروا اختبار اختيار من متعدد، ثم لم يتلقّوا تغذية راجعة، أو تلقّوا تغذية راجعة فورية، أو مؤجلة. في اختبار استرجاع بعد أسبوع، سجّلت المجموعة التي لم تتلقَّ تغذية راجعة 42%؛ ومع التغذية الراجعة الفورية 60%؛ ومع المؤجلة 70% (Butler, Karpicke & Roediger, Journal of Experimental Psychology: Applied, 2007). أي تغذية راجعة كانت المكسب الأكبر، بقيمة 18 إلى 28 نقطة. وأضاف تأجيلها ميزة إضافية.
وهناك أيضًا خطر محدد في تخطّي التغذية الراجعة في اختبارات الاختيار من متعدد. فالخيارات الخاطئة المعقولة قد تُحفظ على أنها حقائق. ووجد المختبر نفسه أن التغذية الراجعة، فورية كانت أو مؤجلة، رفعت الإجابات الصحيحة وقلّلت عدد الخيارات الخاطئة التي أعاد الطلاب إنتاجها لاحقًا كإجابات (Butler & Roediger, Memory & Cognition, 2008). ولهذا يحمل كل سؤال مُنشأ في مركز الدراسة شرحًا قصيرًا للإجابة الصحيحة، ولهذا تعرضه الواجهة قبل أن تتمكن من الانتقال إلى السؤال التالي.
لأسئلة الاختيار من متعدد المحكمة ميزة تفتقر إليها أسئلة الإجابة القصيرة: عندما تكون الخيارات الخاطئة معقولة، فإن معرفة سبب خطئها تعلّمك الحقائق المرتبطة بها أيضًا. فالطلاب الذين أجروا اختبارات اختيار من متعدد ذات بدائل منافِسة تذكّروا لاحقًا معلومات عن الخيارات الخاطئة أفضل من الطلاب الذين أجروا اختبارات استرجاع موجَّه (Little, Bjork, Bjork & Angello, Psychological Science, 2012). لكن بمجرد أن تحقق درجات مريحة، يصبح الاسترجاع دون خيارات هو التمرين الأصعب والأفضل؛ وعندها انتقل إلى أداة الاختبار الكتابي (خطة مدفوعة) أو إلى الإجابة عن كل سؤال بصوت عالٍ قبل النظر إلى الخيارات.
أين يخطئ الذكاء الاصطناعي في أسئلة الاختبار، وكيف تصلح ذلك في دقيقتين
أسئلة الاختبار التي يولّدها الذكاء الاصطناعي جيدة بما يكفي لاستخدامها، لكنها ليست جيدة بما يكفي للثقة بها دون تمحيص. وأفضل الأدلة تأتي من التعليم الطبي، حيث استُخدمت أسئلة الذكاء الاصطناعي في امتحانات حقيقية عالية المخاطر وقُيّمت بالمقاييس النفسية نفسها التي تُقيَّم بها الأسئلة البشرية.
في امتحان لطب الطوارئ، خُلط 100 سؤال كتبها GPT-4o مع 100 سؤال كتبها واضعو أسئلة بشريون. إحصائيًا، ميّزت أسئلة الذكاء الاصطناعي بين الطلاب الأقوياء والضعفاء بقدر ما ميّزت الأسئلة البشرية تقريبًا. لكن مراجعة خبراء معمّاة وجدت 6% من أسئلة الذكاء الاصطناعي غير دقيقة علميًا (مقابل 4% من الأسئلة البشرية)، و6% غير ذات صلة (مقابل 0%)، و14% بمستوى صعوبة غير مناسب (مقابل 1%). كما تجمّعت أسئلة الذكاء الاصطناعي عند مستويي "التذكّر" و"الفهم" في تصنيف بلوم، بينما كانت الأسئلة البشرية أكثر في مستويي "التطبيق" و"التحليل" (Law et al., BMC Medical Education, 2025).
تكمل دراستان لاحقتان الصورة. عندما طُلب من خمسة نماذج رائدة كتابة أسئلة بمستويات بلوم محددة، لم يصب المستويات المطلوبة باستمرار سوى نموذجين؛ وكانت الثلاثة الأخرى أدق في المستويات الأدنى من نوع التذكّر (Nguyen et al., PLOS ONE, 2026). وعندما راجع خبراء أسئلة GPT-4o قبل خلطها في امتحان معمّى، تعرّف 128 من طلاب الطب والأطباء على بنود الذكاء الاصطناعي بدقة 49%، أي ليس أفضل من الصدفة، ولم تُظهر البنود فرقًا قابلًا للقياس في الصعوبة أو القدرة التمييزية (Linde et al., npj Digital Medicine, 2026). أدّت أسئلة الذكاء الاصطناعي المراجَعة أداء الأسئلة البشرية نفسه في ذلك الامتحان. أما غير المراجَعة فصعوبتها رمية عملة.
الإنشاء من مستندك الخاص، كما يفعل مركز الدراسة، يزيل معظم مشكلة عدم الصلة، لأن كل سؤال يجب أن يكون قابلًا للإجابة من ملفك المرفوع. لكنه لا يصلح الميل نحو التذكّر. لذا أجرِ هذه المراجعة على كل اختبار:
هل يطابق الشرح الصفحة التي جاء منها؟
افتح المصدر من الشريط الجانبي لأي سؤال فاجأك. الشرح الذي يضيف تفصيلًا لم تذكره الشرائح أبدًا هو الذي ينبغي أن تشكّ فيه، مهما بدا واثقًا.
هل استطعت الإجابة بمجرد التعرّف على كلمة، أم اضطررت إلى التفكير؟
إذا كانت ثلاثة من الخيارات الأربعة خاطئة بوضوح، فالسؤال فحص تذكّر لا تمرين للامتحان. احتفظ به، لكن لا تدع درجة عالية في مجموعة من هذه الأسئلة تخدعك.
اكتب سؤالًا واحدًا من نوع "لماذا" أو "ماذا لو" بنفسك لكل موضوع أخطأت فيه
ضعه في لوحة الملاحظات بجانب الاختبار. من هنا تأتي أسئلة "التطبيق" و"التحليل" التي تخطّاها الذكاء الاصطناعي، وكتابتها هي نفسها شكل من أشكال ممارسة الاسترجاع. أجب عنها بصوت عالٍ في جولتك التالية.
روتين اختبارات يناسب فصلًا دراسيًا حقيقيًا
تعمل الاختبارات على أفضل وجه بجرعات صغيرة متكررة موزّعة على الأسابيع التي تسبق الامتحان، لا في جلسة طويلة واحدة في الليلة السابقة. يكلّف الروتين أدناه نحو خمس وعشرين دقيقة لكل محاضرة، معظمها من وقت كنت ستفقده على أي حال.
محاضرة واحدة، أربع جلسات اختبار
- قبل المحاضرة (5 دقائق): ارفع الشرائح المنشورة، وأنشئ 10 أسئلة، وأجب عنها دون تحضير. توقّع أن تخطئ في معظمها. هذا هو الاختبار القبلي يؤدي عمله.
- في المساء نفسه (10 دقائق): أعد الاختبار، واقرأ كل شرح، وأجرِ مراجعة الدقيقتين، واكتب أسئلة "لماذا" الخاصة بك في الملاحظات.
- بعد ثلاثة أيام (5 دقائق): جولة أخرى، تجيب فيها عن كل سؤال بصوت عالٍ قبل النظر إلى الخيارات. استمع إلى نسخة البودكاست من الفصل أثناء التنقل أولًا إن كانت لديك.
- الأسبوع السابق للامتحان (5 دقائق لكل محاضرة): أعد اختبار كل محاضرة واحدًا تلو الآخر، ثم أنشئ مجموعة جديدة للفصول الأضعف (إعادة الإنشاء في خطة مدفوعة، أو رفع جديد) حتى لا تكتفي بتذكّر إجابات المجموعة القديمة.
اجمع بين الاختبار والصيغ الأخرى من الرفع نفسه بدل الاختيار بينها. الاختبار يكشف الثغرات؛ ومجموعة البطاقات التعليمية تدرّبك عليها في تكرارات يومية قصيرة؛ والنسخة الصوتية، عبر طريقة القارئ الصوتي للكتب المدرسية، تعيد بناء الألفة في ساعات حين لا تستطيع القراءة. وإن كانت هذه هي الليلة السابقة بالفعل، فإن دليل الدراسة في اللحظة الأخيرة يضغط كل هذا في أمسية واحدة.
كم تكلّف مولّدات الاختبارات بالذكاء الاصطناعي في 2026
ينبغي أن يكون إنشاء اختبار من ملاحظاتك مجانيًا، وهو كذلك في ReadLoudly. معظم المنافسين يتقاضون من $9 إلى $25 شهريًا مقابله أو يحصرونه خلف حصص شهرية صغيرة. هذه هي الأرقام الواردة في صفحات الأسعار الرسمية وقوائم التطبيقات عندما تحققنا في 7 سبتمبر 2026؛ وعدة مزوّدين لا ينشرون أي حد رقمي للخطة المجانية إطلاقًا، لذا يذكر الجدول ذلك بدل التخمين.
| الأداة | اختبار من ملاحظاتك، الخطة المجانية | الخطة المدفوعة |
|---|---|---|
| مركز الدراسة في ReadLoudly | نعم، من PDF أو DOCX أو EPUB، ضمن حصة يومية | $5/شهريًا (ReadLoudly Core)، الأدوات السبع كلها |
| Quizlet | محدود؛ الحد الرقمي غير منشور | خطتا Plus بسعر $9.99 و$44.99 (قائمة iOS) |
| Knowt | حدود شهرية للذكاء الاصطناعي؛ الحد غير منشور | $12.49/شهريًا تُدفع $149.99/سنويًا، أو $24.99/شهريًا |
| Kahoot! | لا إنشاء بالذكاء الاصطناعي في الخطة المجانية | Kahoot!+ من $3/شهريًا تُدفع $36/سنويًا؛ $9 شهريًا |
| Quizgecko | المقرر الأول مجاني | Plus بسعر $9/شهريًا تُدفع $108/سنويًا |
| Wayground (Quizizz) | 10 أرصدة ذكاء اصطناعي شهريًا، و20 عنصرًا محفوظًا | $12/شهريًا تُدفع $144/سنويًا |
| StudyFetch | محدود؛ الحد غير منشور | $19.99/شهريًا أو $96/سنويًا (قائمة iOS) |
ملاحظة منصفة عن المنافسة: Kahoot! وWayground مصممان للمعلمين الذين يديرون اختبارات مباشرة داخل الصف، وهما جيدان في ذلك. وقوة Quizlet في مكتبته من المجموعات المشتركة. لكن أيًا منها لا يُنشئ مجانًا اختبارًا من ملفك المرفوع إلى جانب البطاقات التعليمية والملاحظات ومعلّم من الملف نفسه، مع إضافة البودكاست والاختبار الكتابي في خطة $5، وهذه هي الفكرة كلها من نظام تحويل المستند إلى مجموعة دراسة. وإن كانت ميزانيتك محدودة، فابدأ بـ حزمة الدراسة بالذكاء الاصطناعي بتكلفة $0 ولا تدفع إلا حين تصطدم بحد حقيقي؛ وهذا ما يضيفه ReadLoudly Core عندما تفعل.
أدوات ReadLoudly: مركز الدراسة · الاختيار من متعدد · البطاقات التعليمية · تحويل النص إلى كلام
ابدأ بمحاضرة الغد
اعثر على شرائح محاضرتك القادمة، وارفعها الليلة، وأنشئ عشرة أسئلة، وأجب عنها قبل أن تدخل القاعة. ستخطئ في معظمها، وهذا أفضل تحضير ممكن: ستقع المحاضرة على أسئلة يُبقيها دماغك مفتوحة أصلًا. أعد الاختبار في ذلك المساء مع الشروح، واكتب سؤالين من عندك، وبذلك تكون قد طبّقت الاختبار القبلي وممارسة الاسترجاع والتغذية الراجعة على محاضرة واحدة في أقل من عشرين دقيقة.
الطلاب الذين يستفيدون أكثر من مولّد الاختبارات بالذكاء الاصطناعي ليسوا من يُنشئون أكبر عدد من الاختبارات. بل هم من يجرون الاختبار أولًا، ويقرؤون كل شرح، ويصلحون الأسئلة التي أخطأ فيها الذكاء الاصطناعي، ويعودون بعد ثلاثة أيام. المولّد يتولى الجزء الذي كان يحتاج إلى معلّم. والباقي عادة يستغرق بناؤها أسبوعًا.
أجرِ الاختبار قبل أن يطرح الأستاذ الأسئلة
ارفع ملف PDF أو DOCX أو EPUB واحدًا، وحدّد الاختيار من متعدد، واحصل على 5 إلى 20 سؤالًا مع الشروح في نحو دقيقة. ابدأ مجانًا، دون بطاقة ائتمان، والخطة المدفوعة بسعر $5 لا $20.
أنشئ اختبارًا من ملاحظاتي