Forschungsarbeit anhören: 5 PDF-Audiofehler beheben
Zwei Spalten, die quer über den Zwischenraum gelesen werden, Zitate in voller Länge, Notation ohne gesprochene Form, Bildunterschriften mitten im Satz, Scans ohne Textebene. Der Mechanismus hinter jedem Fehler und die Lösung.
„Ein vorgelesener Roman klingt wie ein Roman. Ein vorgelesener Fachartikel klingt oft, als würde jemand zwei Kartenstapel mischen. Das liegt nicht an der Stimme. Es liegt am Seitenlayout.“
Drücke auf Play bei einem Kapitel aus einem Taschenbuch, und es funktioniert. Drücke auf Play bei einem zweispaltigen Journal-PDF, und der erste Satz kommt als flüssige, grammatisch korrekte, völlig bedeutungslose Folge von Halbsätzen an. Die meisten schließen daraus, dass die Stimme schlecht ist, probieren drei weitere Apps aus und bekommen dasselbe Ergebnis.
Wissenschaftliche PDFs scheitern an Text-to-Speech aus strukturellen Gründen, die nichts mit der Sprachsynthese zu tun haben. Unten findest du den Mechanismus hinter jedem Fehler und was du dagegen tun kannst. Für den Ablauf darauf aufbauend (wie viele Durchgänge, welches Tempo, welche Abschnitte) siehe den Leitfaden zum Vorlesen von Forschungsarbeiten.
Das Wichtigste in Kürze
- Ein PDF speichert Zeichenpositionen, keine Lesereihenfolge. Zweispaltige Paper werden quer über den Spaltenzwischenraum gelesen, weil nichts in der Datei sagt, dass die Spalten getrennt sind.
- Fünf Fehler verursachen fast jedes Scheitern: der Spaltenzwischenraum, Zitate im Text, Notation, schwebende Bildunterschriften und Fußnoten sowie eine fehlende Textebene.
- Zwei Minuten Prüfen sparen eine Stunde. Höre den ersten Absatz der Einleitung an, bevor du dich auf ein Paper mit 40 Seiten festlegst.
- Bei mathematiklastigen Papern sei ehrlich über die Grenze. Audio liefert dir die Argumentation. Die Notation liefert es nicht, und keine Stimme behebt das.
Die Kurzantwort
Wissenschaftliche Paper scheitern an Text-to-Speech, weil ein PDF festhält, wo jedes Zeichen auf der Seite sitzt, nicht in welcher Reihenfolge ein Mensch sie liest. Der Satz von Fachzeitschriften bringt vier weitere Stolperfallen mit: Zitate im Text, mathematische Notation, schwebende Bildunterschriften und gescannte Seiten ganz ohne maschinenlesbaren Text.
Für jeden der fünf Fehler gibt es eine konkrete Lösung, und keine davon lautet „such dir eine bessere Stimme“. Finde den Fehler, wende das Mittel an, und die meisten Paper werden hörbar. Eine Minderheit (dichte Beweise, Theorie mit Notation im Vordergrund) wird es nie, und zu wissen, welche das sind, ist der Großteil der Kunst.
Warum ein Paper einen Reader aus dem Tritt bringt, ein Roman aber nicht
Die Ursache ist, dass ein PDF die Beschreibung einer gedruckten Seite ist, keine Dokumentstruktur. Wenn eine Setzerin oder ein Setzer einen Zeitschriftenartikel erzeugt, sagt die entstehende Datei sinngemäß: Setze das Zeichen „T“ an diese Koordinate, dann „h“ etwas rechts davon, und so weiter für jedes Zeichen der Seite. Es gibt keinen Absatz und keine Spalte. Diese Dinge existieren in deiner visuellen Wahrnehmung der Seite, nicht in der Datei.
Ein Reader muss deshalb die Lesereihenfolge aus der Geometrie rekonstruieren, Zeichen zu Zeilen und Zeilen zu Blöcken gruppieren. Bei einem Roman ist das trivial: eine Spalte, gleichmäßige Ränder, nichts Schwebendes. Bei einem Zeitschriftenartikel ist es ein echtes Schlussfolgerungsproblem, und die Layoutkonventionen der Wissenschaft sind dafür nahezu der schlimmste Fall.
Deshalb verhalten sich auch die Verlagsversion und das Preprint der Autorinnen und Autoren eines Artikels oft unterschiedlich: andere Satz-Pipelines. Mit deinen Stimmeinstellungen hat das nichts zu tun.
Das nützliche Denkmodell: Dein Reader liest das Paper nicht. Er rät, in welcher Reihenfolge die Zeichen auf der Seite gelesen werden sollten. Alles Folgende sind Fälle, in denen der wissenschaftliche Satz dieses Raten schwer macht.
Fehler 1: Der Spaltenzwischenraum, in dem zwei Spalten zu einem Satz werden
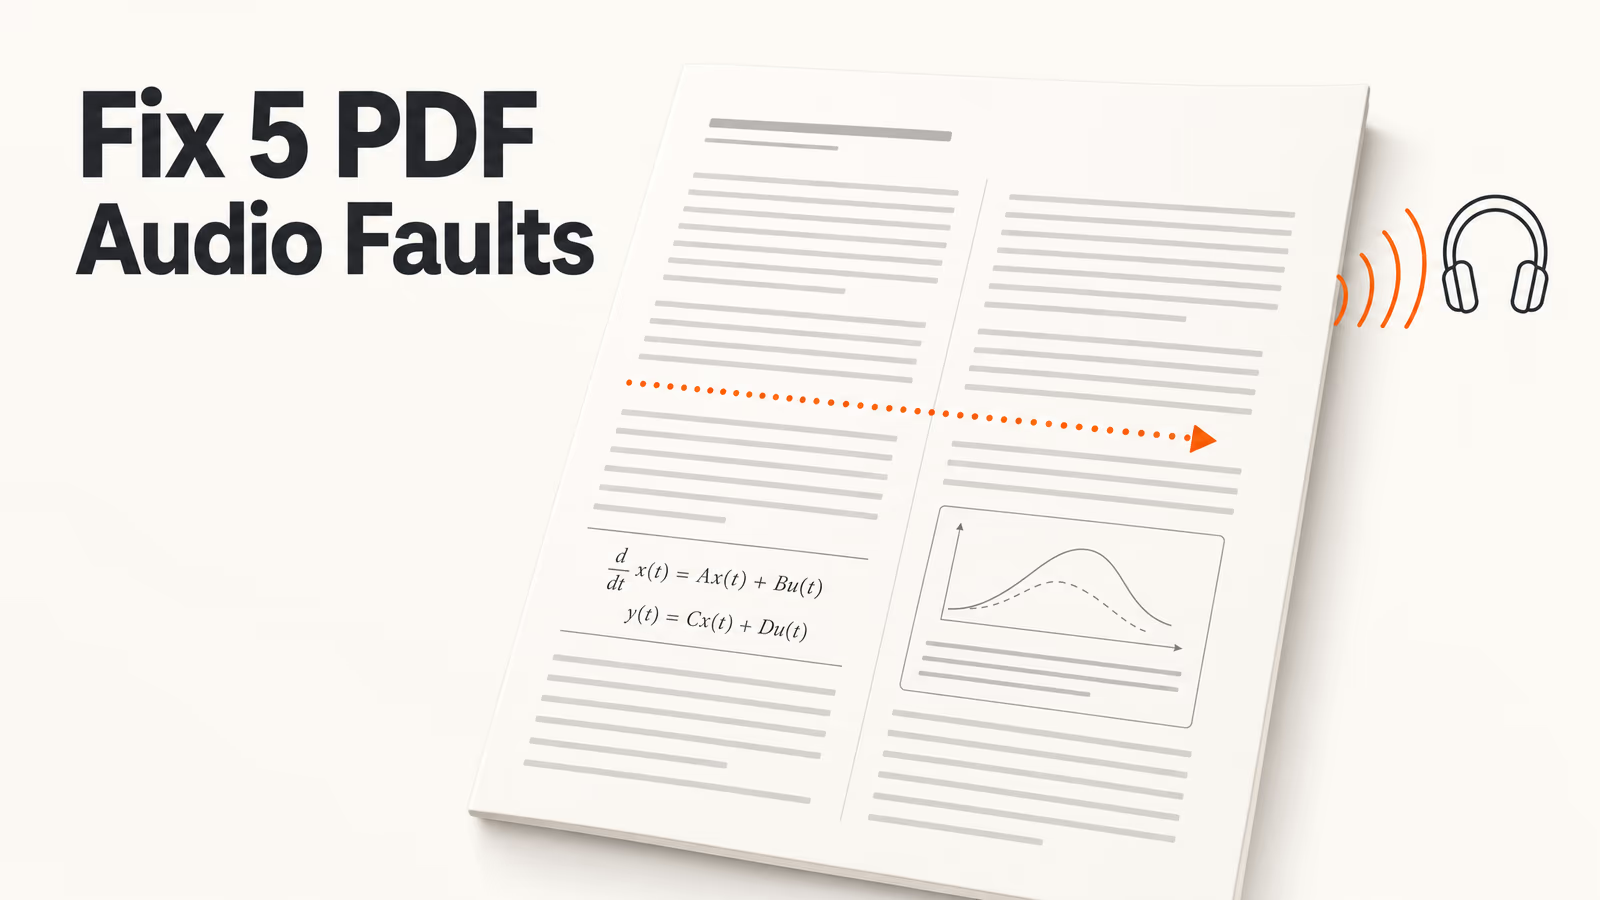
Das ist der häufigste Fehler und der am leichtesten erkennbare: Das Audio ist flüssig, aber bedeutungslos, weil auf jede gesprochene Zeile der linken Spalte sofort die Zeile der rechten Spalte folgt. Du hörst grammatische Fragmente, die an unzusammenhängende gehängt werden, etwa alle sechs bis zwölf Wörter.
Das passiert, wenn die Extraktion ein horizontales Band der Seite als eine Textzeile behandelt. Beide Spalten liegen in diesem Band, also werden beide gelesen, von links nach rechts, quer über den Weißraum dazwischen. Dieser Weißraum ist für dich ein visuelles Signal und für die Extraktion gar nichts.
Das kannst du tun, geordnet nach dem Aufwand für dich:
- Teste, bevor du dich festlegst. Spiele den ersten Absatz der Einleitung ab. Wenn der zweite Teilsatz nicht aus dem ersten folgt, hast du das Spaltenproblem, und es hat dich zwanzig Sekunden gekostet, das herauszufinden.
- Nutze einen Reader, der Spalten erkennt. Spaltenbewusste Extraktion liest die linke Spalte bis zum Seitenende, bevor sie die rechte beginnt. Der PDF-Reader von ReadLoudly verarbeitet mehrspaltige wissenschaftliche Layouts, und weil er den gesprochenen Satz markiert, siehst du sofort, ob die gewählte Reihenfolge zur Seite passt.
- Bevorzuge die einspaltige Version, wenn es eine gibt. Viele Autorinnen und Autoren stellen ein Preprint im einspaltigen Format bereit: derselbe Text, eine viel leichter vorzulesende Datei.
Falsch geordnetes Audio ist nach Gehör schwer zu erkennen, weil die Stimme selbstsicher klingt und jedes Fragment wohlgeformt ist. Sobald du die Markierung seitwärts über die Seite springen siehst, ist es offensichtlich.
Fehler 2: Zitat-Rauschen und warum dichte Absätze zu Statik werden
Zitate im Text sind dafür geschrieben, vom Auge übersprungen zu werden, und lassen sich vom Ohr nicht überspringen. Eine glatte schriftliche Aussage kommt im Audio durchsetzt von Ketten aus Namen, Jahreszahlen und Zahlen in Klammern an.
Nimm einen typischen Satz aus einem Literaturüberblick im Autor-Jahr-Stil: ein Teilsatz, dann vier Verweise in Klammern, dann der Rest des Teilsatzes. Beim Lesen überspringt dein Auge die Klammer in Sekundenbruchteilen. Beim Zuhören bekommst du jeden Nachnamen und jedes Jahr in voller Länge, und bis der Satz weitergeht, hast du sein Subjekt verloren. Nummerische Stile sind kürzer, aber in einer Hinsicht schlimmer: Eine hochgestellte Zahl kann ohne Pause am vorigen Wort hängen, sodass der Satz mittendrin unbemerkt Ziffern bekommt.
Drei Dinge helfen:
- Erwarte in Einleitung und Diskussion keine Prosa. Diese Abschnitte sind von Natur aus zitatdicht. Höre auf die Form der Argumentation, nicht auf Sätze.
- Erhöhe das Tempo bei referenzlastigen Passagen, nicht beim ganzen Paper. Du verarbeitest bewusst weniger, was bibliografisch statt inhaltlich ist.
- Behandle das Literaturverzeichnis als eigenes Dokument. Hör es dir nie an. Springe vom Ende der Diskussion zum nächsten Paper und sieh dir die Bibliografie mit den Augen an.
Wenn du große Mengen an Literatur sichtest, kommt es mehr auf die Reihenfolge an als auf die Audioqualität je Paper: Der Audio-Workflow für einen Paper-Stapel zeigt, wie du die Warteschlange ordnest.
Fehler 3: Gleichungen, bei denen Audio an eine echte Grenze stößt
Dafür gibt es keine Lösung, plane also darum herum, statt ein Tool zu suchen, das es löst. Mathematische Notation hat keine verlässliche gesprochene Form, deshalb muss ein Reader zwischen etwas Falschem, etwas Mehrdeutigem oder nichts wählen.
Drei Probleme kommen zusammen. Erstens ist die meiste Notation in einem PDF gar nicht als Mathematik gespeichert: Es sind Zeichen, die so positioniert sind, dass sie wie eine Gleichung aussehen, sodass Indizes, Bruchstriche und Integralgrenzen Geometrie statt Struktur sind. Zweitens ist selbst gut verstandene Notation laut gesprochen mehrdeutig. „x Quadrat durch zwei“ kann das Quadrat von x geteilt durch zwei sein oder x hoch ein Halb; die Klammern, die das klären, sind visuell. Drittens beruht mathematische Argumentation darauf, mehrere Ausdrücke gleichzeitig im Blick zu halten, und genau das nimmt Audio weg.
Die ehrliche Schlussfolgerung: Bei mathematiklastigem Material ist Audio ein guter Weg zur Argumentation und ein schlechter zur Notation. Du kannst einen Methodenteil anhören und wissen, dass die Autorinnen und Autoren ein Modell regularisiert haben, warum sie diesen Strafterm gewählt haben und was er ihrer Aussage nach gebracht hat. Die Gleichung selbst kannst du danach nicht reproduzieren.
Nutze Audio also für die Prosa über die Begründung und lies Notation mit den Augen: Abstract, Einleitung, Diskussion und die erzählenden Absätze der Methoden nach Gehör, Herleitungen am Bildschirm. Paper, deren Beitrag die Herleitung ist, sind keine Audio-Kandidaten, und sie so zu behandeln, verschwendet eine Stunde, bevor du es zugibst.
Fehler 4: Bildunterschriften, Fußnoten und Kolumnentitel, die mitten im Satz dazwischenfunken
Eine Bildunterschrift gehört nicht zum Satz daneben, liegt aber im selben Seitenband, deshalb wird sie oft mitten in diesem Satz gelesen. Das Symptom ist unverkennbar: Du folgst einem Absatz, als die Stimme „Abbildung 3. Mittlere Reaktionslatenz nach Bedingung“ sagt und dann deinen Absatz dort fortsetzt, wo er unterbrochen wurde.
Alles, was auf einer wissenschaftlichen Seite schwebt, tut das: Bildunterschriften, Fußnoten, der Kolumnentitel mit Zeitschriftenname und Seitenzahl, der DOI-Block, die Ausgabenzeile am Rand. Das alles ist Text an einer Koordinate, und ein Reader, der von Geometrie ausgeht, hat keinen begründeten Weg zu wissen, dass es Beiwerk statt Prosa ist.
Was wirklich hilft:
- Verstehe „Abbildung 3“ als Hinweis, später hinzusehen. Merke dir die Stelle und mach weiter. Jedes Mal anzuhalten, um die Abbildung zu suchen, zerstört den Grund, warum du zuhörst; Abbildungen am Ende in einem visuellen Durchgang zu bündeln ist fast immer besser.
- Überspringe das Beiwerk der ersten Seite. Titelseiten enthalten die dichteste Folge aus Kopfzeilen, Zugehörigkeiten, DOIs und Einreichungsdaten. Wenn du beim Abstract statt oben auf Seite eins beginnst, entfällt viel Rauschen.
- Überspringe Tabellen komplett. Nach Geometrie gelesen, liefert eine Tabelle Zahlen in einer Reihenfolge ohne Bedeutung. Tabellen sind zum Ansehen da, nicht zum Hören.
Fehler 5: Das Paper ganz ohne Textebene
Wenn ein Reader ein leeres Dokument meldet oder Stille abspielt, ist die Datei fast sicher ein Scan: ein Bild einer Seite ohne Zeichen darin. Das ist bei allem üblich, was aus dem Druck digitalisiert wurde, also bei einem großen Teil der Literatur vor Mitte der 1990er.
Du kannst das in zwei Sekunden ohne Tool bestätigen: Versuche, in deinem PDF-Viewer eine Textzeile auszuwählen. Zieht der Cursor stattdessen ein Rechteck über die Seite, statt Wörter zu markieren, gibt es nichts zu lesen. Eine fotografierte Seite verhält sich genauso.
Die Lösung ist optische Zeichenerkennung (OCR), die das Bild des Textes zurück in Zeichen umwandelt. Lass sie vor dem Start über das ganze Paper laufen, rechne bei schlechten Scans (verblasste Tinte, schiefe Seiten und handschriftliche Anmerkungen kosten Genauigkeit) mit unvollkommenem Ergebnis und beachte, dass eine gescannte zweispaltige Seite zusätzlich Fehler 1 erbt. Ein Reader mit eingebauter OCR spart den Umweg über einen separaten Konvertierungsschritt: Der Reader für gescannte PDFs erkennt den Text und spricht ihn in einem Durchgang, und die Methode für physische Seiten und Bibliotheksfotos findest du unter ein Buch scannen und es sich vorlesen lassen.
Der Zwei-Minuten-Check vorab
Mach ihn, bevor du dich auf irgendein Paper festlegst. Zwei Minuten hier sind der Unterschied zwischen einer nützlichen Einheit und einer Stunde selbstsicheren Unsinns.
| Was du hörst | Die Ursache | Was du tun kannst |
|---|---|---|
| Flüssige Fragmente, die nicht zusammenhängen | Zwei Spalten werden quer über den Zwischenraum gelesen | Spaltenbewussten Reader nutzen; auf die Markierung achten; einspaltiges Preprint bevorzugen |
| Stille oder ein leeres Dokument | Gescannte Seiten ohne Textebene | Zuerst OCR über die ganze Datei laufen lassen |
| Namen und Jahreszahlen überfluten den Satz | Zitate im Text werden vollständig gesprochen | Tempo bei dichten Passagen erhöhen; das Literaturverzeichnis nie abspielen |
| Eine Bildunterschrift oder Kopfzeile mitten im Absatz | Schwebendes Seitenbeiwerk im selben Band | Beim Abstract beginnen; Abbildungen markieren und visuell bündeln |
| Symbolketten werden als Wörter gelesen | Notation hat keine gesprochene Form | Auf die Argumentation hören; Herleitungen am Bildschirm lesen |
| Wörter, die an Zeilenenden mittendrin getrennt sind | Trennstriche bei Zeilenumbrüchen werden wörtlich übernommen | Bei Tempo meist harmlos; ein spaltenbewusster Reader fügt die meisten wieder zusammen |
Eine Gewohnheit deckt den Großteil der Tabelle ab: Spiele den ersten Absatz der Einleitung ab und frag dich, ob der zweite Satz aus dem ersten folgt. Wenn ja, ist die Extraktion in Ordnung. Wenn nicht, behebe die Datei, bevor du die Stunde investierst. Derselbe Check eröffnet die Methode zum Anhören langer PDFs.
Zuhören ist Input, keine Wiederholung
Sauberes Audio löst das Extraktionsproblem und lässt ein zweites unberührt. Zuhören ist eine Input-Tätigkeit, genau wie Lesen. Einmal gemacht, gelangt davon sehr wenig ins dauerhafte Gedächtnis. Das schafft Abruf: eine Frage, die du ohne die Quelle vor dir beantworten musst.
Bei Papern schlägt das stärker zu als bei den meisten Materialien, denn was du Wochen später brauchst, ist selten die Prosa. Es sind die Aussage, die Methode, die Stichprobe, die Einschränkung und die Zahl.
Der letzte Schritt einer Hörsitzung ist also kein Hörschritt. Aus einem Upload kann dasselbe Paper werden:
- Ein Set aus Karteikarten zu Begriffen, Messgrößen und Definitionen, also dem Teil eines Papers, der reines Auswendiglernen ist.
- Ein Quiz zu Methoden und Ergebnissen, der schnellste Weg zu entdecken, dass eine Passage, der du gefolgt zu sein glaubtest, nicht angekommen ist.
- Eine Podcast-Diskussion mit zwei Sprecherinnen oder Sprechern über das Paper: ein wirklich anderer Durchgang durch dieselben Ideen, nützlich auf dem zweiten Arbeitsweg, wo das erneute Abspielen des Originals bloße Wiederholung wäre.
- Eine Tutor-Sitzung oder ein schriftliches Übungsset zu allem, was das Quiz offengelegt hat.
Das ist das Argument für ein Tool, das aus einem Dokument ein Lernset macht, statt ein PDF in eine MP3 zu verwandeln und in eine Podcast-App zu legen. Das Audio bringt dich durch die Literaturmenge; die Fragen sind es, die das Lesen zählen lassen, und das vollständige System vom Dokument zum Lernset zeigt dir die Abfolge. Du bist noch unsicher, ob Audio überhaupt in deine Routine gehört? Das Plädoyer fürs Anhören von Papern geht darauf ein.
Beginne mit dem Check vorab beim nächsten Paper in deiner Warteschlange: Spiele einen Absatz ab, entscheide, welchen der fünf Fehler du vor dir hast, und behebe diesen statt der Stimme.
Wenn dein Dokument eine echte Textebene hat und eine Gerätestimme reicht, sind diese eingebauten Reader von ihren Herstellern dokumentiert: Microsoft Edge Vorlesen, Android „Zum Sprechen auswählen“ und Apple Gesprochene Inhalte.