टेक्स्ट निकालें PDF से
साफ़, तेज़ और प्राइवेट
फ़्री PDF to Text कन्वर्टर। साफ़ टेक्स्ट निकालता है, हेडर, फ़ुटर और पेज नंबर हटाता है, OCR से स्कैन किए PDF संभालता है। आपके ब्राउज़र में चलता है।
ReadLoudly रीडर में खुलता है। फ़्री, साइन अप की ज़रूरत नहीं।
सुनने से पहले वॉइस सुनें
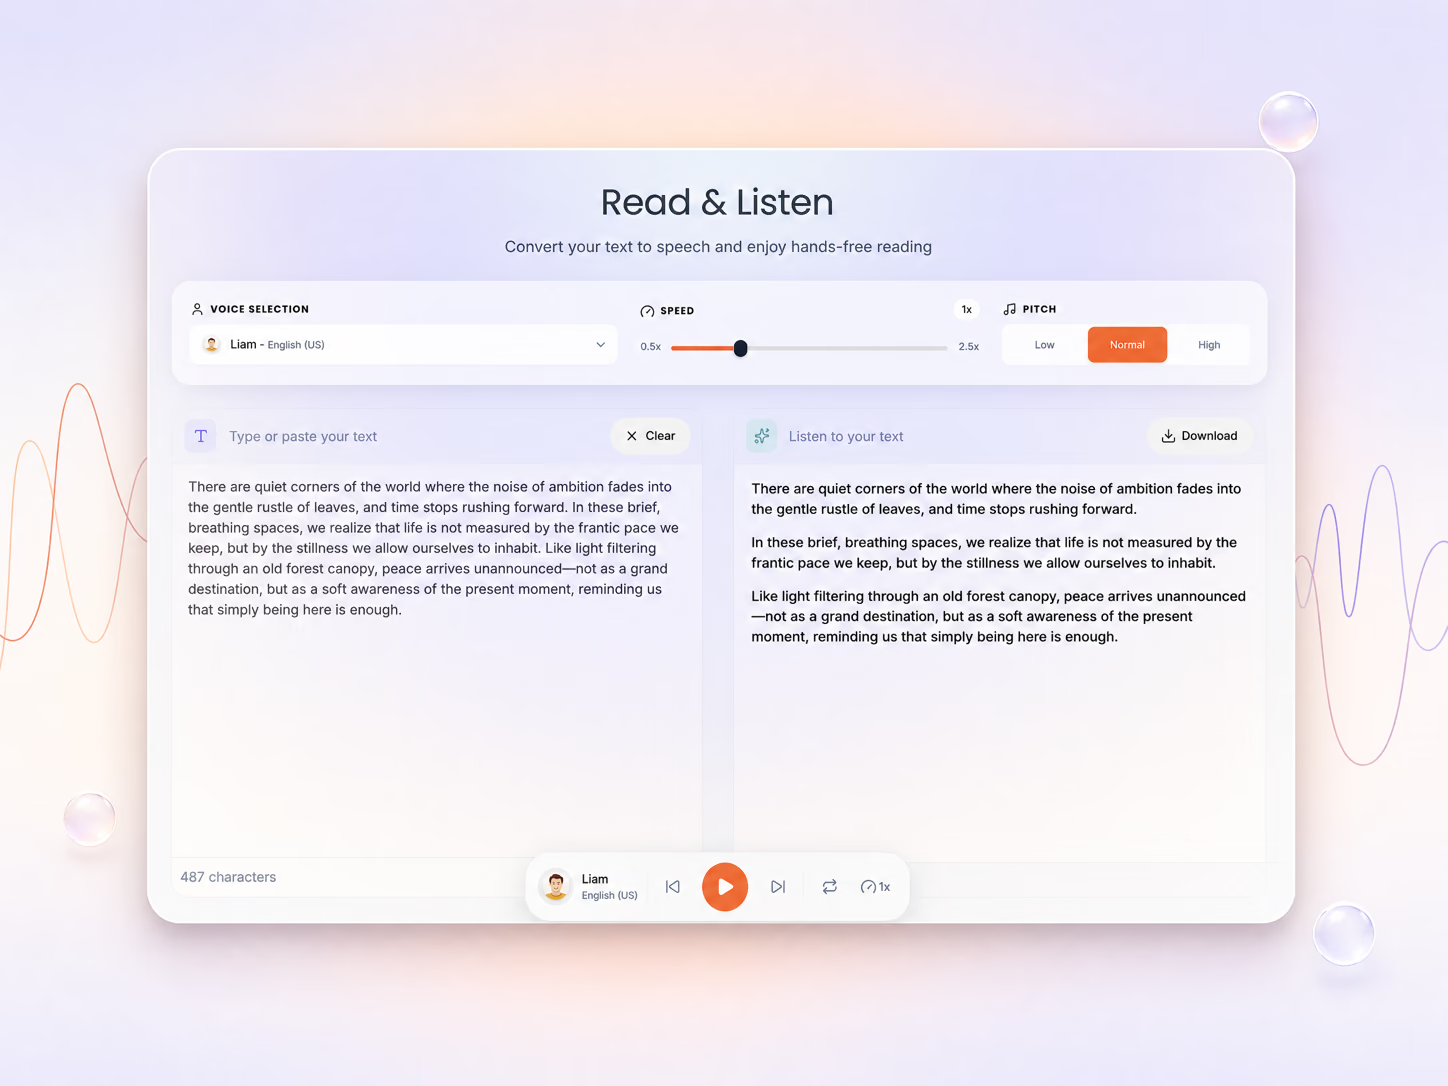
एक्सट्रैक्शन विकल्प
निकाला गया टेक्स्ट
एडिट होने लायक — कॉपी या डाउनलोड करने से पहले टेक्स्ट में बदलाव करें।
PDF से टेक्स्ट कैसे निकालें
किसी भी PDF को सेकंडों में साफ़, एडिट करने लायक टेक्स्ट में बदलें — सीधे अपने ब्राउज़र में।
अपना PDF अपलोड करें
अपनी फ़ाइल जोड़ें — टेक्स्ट वाले और स्कैन किए, दोनों PDF चलते हैं।
इसे निकालने दें
हेडर, फ़ुटर और पेज नंबर हटा दिए जाते हैं; स्कैन OCR से पढ़े जाते हैं।
कॉपी या डाउनलोड करें
नतीजा एडिट करें, फिर उसे कॉपी करें या .txt फ़ाइल के रूप में सेव करें।
साफ़ टेक्स्ट, सिर्फ़ कच्चा एक्सट्रैक्शन नहीं
ज़्यादातर PDF एक्सट्रैक्टर सब कुछ उगल देते हैं — हर पेज पर छपे पेज नंबर और जर्नल के नाम समेत। ReadLoudly उस दोहराई जाने वाली गंदगी को पहचानकर हटा देता है और आपके पास वही कंटेंट छोड़ता है जो आप सचमुच चाहते हैं।
ऑटो-क्लीनअप
चलते हेडर, फ़ुटर और पेज नंबर हटाता है, ताकि आप लेआउट के शोर की जगह साफ़ गद्य कॉपी करें।
स्कैन के लिए OCR
सिर्फ़ इमेज वाले और स्कैन किए PDF ब्राउज़र के भीतर OCR से पढ़े जाते हैं — अलग टूल की ज़रूरत नहीं।
100% प्राइवेट
सारी प्रोसेसिंग आपके ब्राउज़र में होती है। आपका PDF किसी सर्वर पर कभी अपलोड नहीं होता।
संबंधित टूल्स
आपके वर्कफ़्लो को तेज़ करने वाले और PDF टूल।
अक्सर पूछे जाने वाले सवाल
PDF to Text – Extract Text from PDF Free | ReadLoudly के बारे में आपको जो जानना चाहिए, सब कुछ।
अपना PDF ReadLoudly के PDF to Text टूल में अपलोड करें और टेक्स्ट आपके ब्राउज़र में तुरंत निकल आता है। आप उसे कॉपी कर सकते हैं, वहीं एडिट कर सकते हैं, या .txt फ़ाइल के रूप में डाउनलोड कर सकते हैं — अकाउंट नहीं, सर्वर पर अपलोड नहीं, सॉफ़्टवेयर इंस्टॉल नहीं।
हाँ। टूल पेजों में एक ही जगह दोहराए जाने वाले टेक्स्ट — चलते हेडर और फ़ुटर — अपने आप पहचानता है और अकेले पेज नंबर हटा देता है, ताकि आपको साफ़ बॉडी टेक्स्ट मिले। अगर आप कच्चा एक्सट्रैक्शन चाहते हैं तो इसे बंद कर सकते हैं।
हाँ। अगर PDF में एम्बेडेड टेक्स्ट नहीं है, तो ReadLoudly पेज की इमेज से टेक्स्ट पढ़ने के लिए सीधे आपके ब्राउज़र में OCR (Optical Character Recognition) चलाता है। OCR सामान्य एक्सट्रैक्शन से धीमा है पर स्कैन किए डॉक्यूमेंट से भी टेक्स्ट निकालने देता है।
हाँ — PDF to Text – Extract Text from PDF Free फ़्री है, शुरू करने के लिए साइन अप की ज़रूरत नहीं और आउटपुट पर कोई वॉटरमार्क नहीं। Core ($5/माह), Plus ($10/माह) और Pro ($19/माह) फ़ाइल साइज़ सीमा बढ़ाते हैं, सभी 1,200+ AI वॉइस खोलते हैं, और प्रीमियम वॉइस में पढ़े गए पेस्ट किए टेक्स्ट का MP3 डाउनलोड तथा प्रायॉरिटी प्रोसेसिंग जोड़ते हैं।
ReadLoudly 24 फ़ाइल फ़ॉर्मैट ज़ोर से पढ़ता है: डॉक्यूमेंट (PDF, DOCX, ODT, RTF), ई-बुक (EPUB, MOBI, AZW, FB2, CHM, LRF, LIT, PDB, RB), टेक्स्ट और वेब फ़ाइलें (TXT, HTML), कॉमिक्स (CBR, CBZ), और इमेज (OCR के ज़रिए) (JPG, PNG, GIF, BMP, WEBP, TIFF, SVG)। हर फ़ॉर्मैट का अपना अलग रीडर पेज है, और सभी में वही 1,200+ AI वॉइस इस्तेमाल होती हैं।
ReadLoudly में 40+ भाषाओं में 1,200+ नेचुरल AI वॉइस हैं, और ज़्यादातर भाषाओं में कई एक्सेंट तथा पुरुष, महिला और न्यूट्रल विकल्प हैं। स्पीड 0.5x से 2.5x तक जाती है, और Pro में पिच कंट्रोल भी मिलता है।
हाँ। PDF to Text – Extract Text from PDF Free iOS और Android के मोबाइल ब्राउज़र में बिना कुछ इंस्टॉल किए चलता है, इसलिए आप फ़ोन के Files ऐप, ईमेल अटैचमेंट या क्लाउड ड्राइव की फ़ाइल से काम कर सकते हैं। साइन इन यूज़र की लाइब्रेरी और पोज़ीशन उनके अकाउंट में सेव रहती है, जो किसी भी ब्राउज़र पर उपलब्ध है।
फ़ाइलें प्रोसेस होकर हटा दी जाती हैं। ReadLoudly आपके डॉक्यूमेंट पर मॉडल ट्रेन नहीं करता, उन्हें तीसरे पक्ष से शेयर नहीं करता, और किसी और को दिखाई नहीं देने देता। साइन-इन यूज़र चाहें तो फ़ाइल अपनी प्राइवेट लाइब्रेरी में रख सकते हैं; गेस्ट अपलोड लगभग 24 घंटे बाद हटा दिया जाता है।
PDF के साथ काम करने के बारे में और
ReadLoudly ब्लॉग की गाइड और तुलनाएँ, जो अपने डॉक्यूमेंट सुनने का ज़्यादा फ़ायदा उठाना सिखाती हैं।
आज से स्मार्ट तरीक़े से सुनना शुरू करें
उन 4M+ पाठकों से जुड़ें जिन्होंने कंटेंट पढ़ने का तरीका बदल दिया है। किसी भी डॉक्यूमेंट को सेकंडों में दिलचस्प ऑडियो अनुभव में बदलें।